Strategia AI
Wdrożenia Data & AI
Harness czy model? Co decyduje o jakości AI w firmie (2026)
Maciej Rutkowski | CEO WeAreFuture
Latem 2026 roku w sieci rozgorzał spór, który dobrze pokazuje zamieszanie wokół AI w firmach. Jedni praktycy twierdzą, że różnica między modelami open source a najlepszymi modelami frontier jest już praktycznie pomijalna. Inni, że dzieli je przepaść. Obie strony brzmią przekonująco, bo obie mają rację, tylko mówią o czymś innym.
To nie jest spór akademicki. To pytanie, za które płaci Twój budżet. Jeśli różnica między modelami jest pomijalna, bierzesz najtańszy i cieszysz się oszczędnością. Jeśli jest ogromna, albo przepłacasz, albo wdrażasz coś, co nie działa. A prawdziwa odpowiedź, dla większości zastosowań biznesowych, brzmi inaczej niż obie skrajności: o wyniku nie decyduje wybór modelu. Decyduje harness, czyli cała obudowa, w którą model jest wpięty.
To zdanie ma jednak drugą połowę, którą pomija większość dyskusji, i to właśnie ona chroni Cię przed kosztownym błędem: harness nie jest przenośny między modelami. „Harness ma większe znaczenie niż model" nie znaczy więc „możesz podmienić model na tańszy bez kosztu". Ten artykuł jest o tym, jak te dwie rzeczy pogodzić i co z nich wynika dla Twoich decyzji. Piszę z perspektywy praktyka: WeAreFuture to polska firma doradczo-wdrożeniowa AI z Warszawy, która buduje agentów i automatyzacje dla średnich i dużych firm.
Czym jest harness w AI?
Harness to cała obudowa, która zamienia surowe wagi modelu w działający system. Termin przyszedł ze świata testowania modeli (evaluation harness, jak otwarte lm-evaluation-harness od EleutherAI). Model sam z siebie tylko generuje tekst. Harness sprawia, że z tego generowania powstaje coś, co wykonuje zadanie.
Na harness składa się siedem warstw:
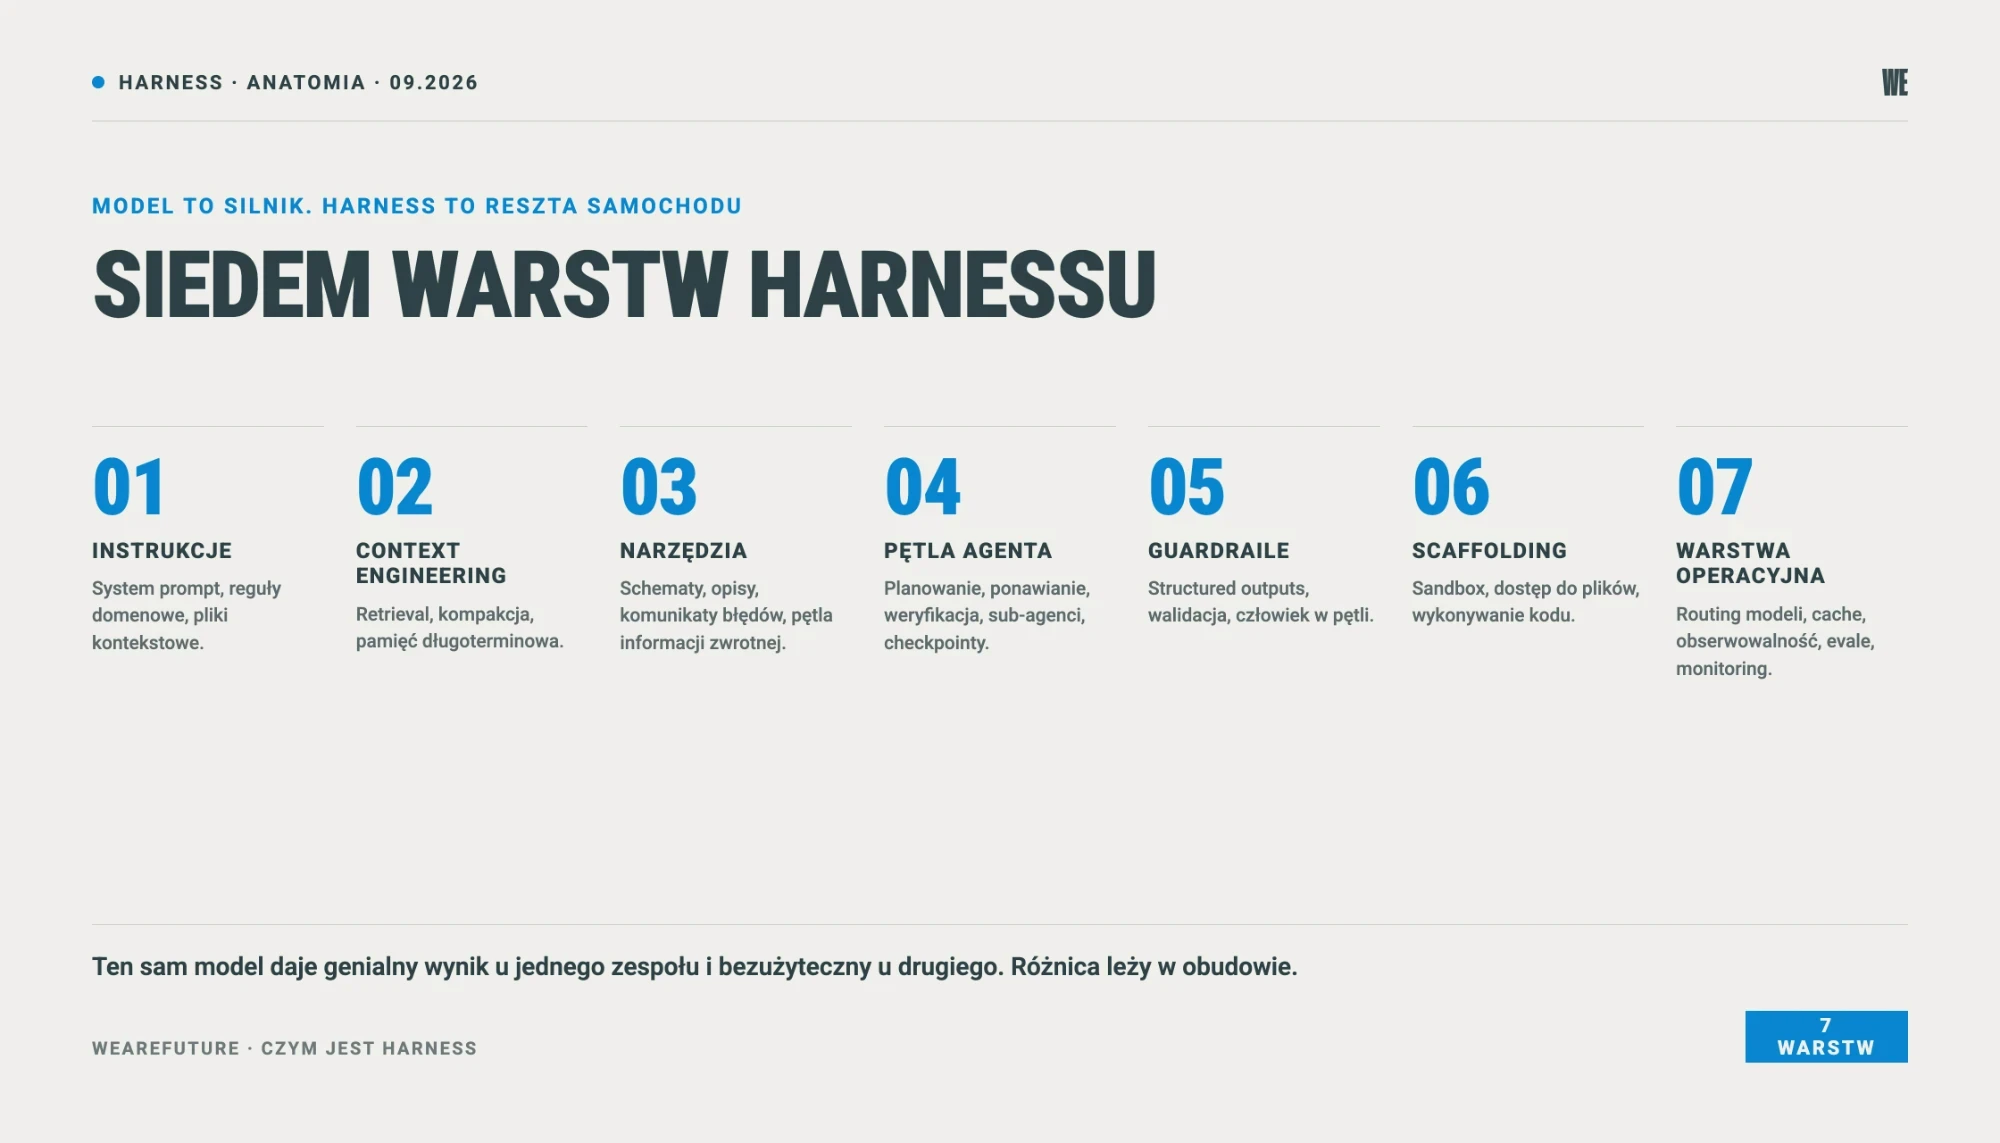
Harness AI to siedem warstw wokół modelu: od instrukcji i kontekstu po evale i monitoring.
Instrukcje: system prompt, reguły domenowe, pliki kontekstowe (typu CLAUDE.md), które mówią modelowi, jak ma działać.
Context engineering: co trafia do okna kontekstu: retrieval, kompakcja, pamięć długoterminowa. To decyduje, czy model ma z czego korzystać. Anthropic opisuje to jako osobną dyscyplinę w tekście Effective context engineering for AI agents.
Narzędzia: schematy narzędzi, jakość ich opisów, treść komunikatów błędów i pętla informacji zwrotnej, dzięki której model wie, czy jego akcja się udała.
Pętla agenta: planowanie, ponawianie prób, weryfikacja wyniku, podział na sub-agentów, checkpointy.
Guardraile: wymuszone struktury odpowiedzi (structured outputs), walidacja, człowiek w pętli tam, gdzie stawka jest wysoka.
Scaffolding: sandbox, dostęp do plików, wykonywanie kodu, czyli środowisko, w którym agent działa.
Warstwa operacyjna: routing między modelami, cache, obserwowalność, testy (evale) i monitoring regresji.
Najprostsza metafora: silnik z bolidu Formuły 1 wrzucony do seryjnego nadwozia, bez odpowiedniej skrzyni biegów, aerodynamiki i telemetrii, nie pojedzie szybciej niż zwykły samochód. Model to silnik. Harness to reszta samochodu i cały zespół w boksie. Sam silnik nie wygrywa wyścigu.
I to jest sedno sporu, od którego zaczęliśmy. Kiedy dwie firmy dają ten sam problem dwóm różnym modelom, ale w dwóch różnych harnessach, różnica w wyniku bierze się w większości z obudowy, a nie z modelu. Dlatego ten sam model potrafi dać genialny wynik u jednego zespołu i bezużyteczny u drugiego.
Widać to w benchmarkach. LangChain podniósł wynik swojego agenta kodującego w Terminal Bench 2.0 z 52,8% do 66,5%, zmieniając wyłącznie harness, bez zmiany modelu (LangChain, Improving Deep Agents with harness engineering). Autorzy pracy „Stop Comparing LLM Agents Without Disclosing the Harness" (maj 2026) pokazują, że przy zadaniach długohoryzontowych zmiana obudowy potrafi przesunąć wynik mocniej niż zmiana modelu, łącznie z odwróceniem rankingu modeli.
Dlaczego obie strony sporu mają rację?
Jedni widzą pomijalną różnicę między modelami, a inni przepaść, z powodu prostej matematyki: propagacji błędu.
W zadaniu wielokrokowym skuteczność całości to skuteczność pojedynczego kroku podniesiona do potęgi równej liczbie kroków. Im dłuższe zadanie, tym mocniej drobne różnice się kumulują.
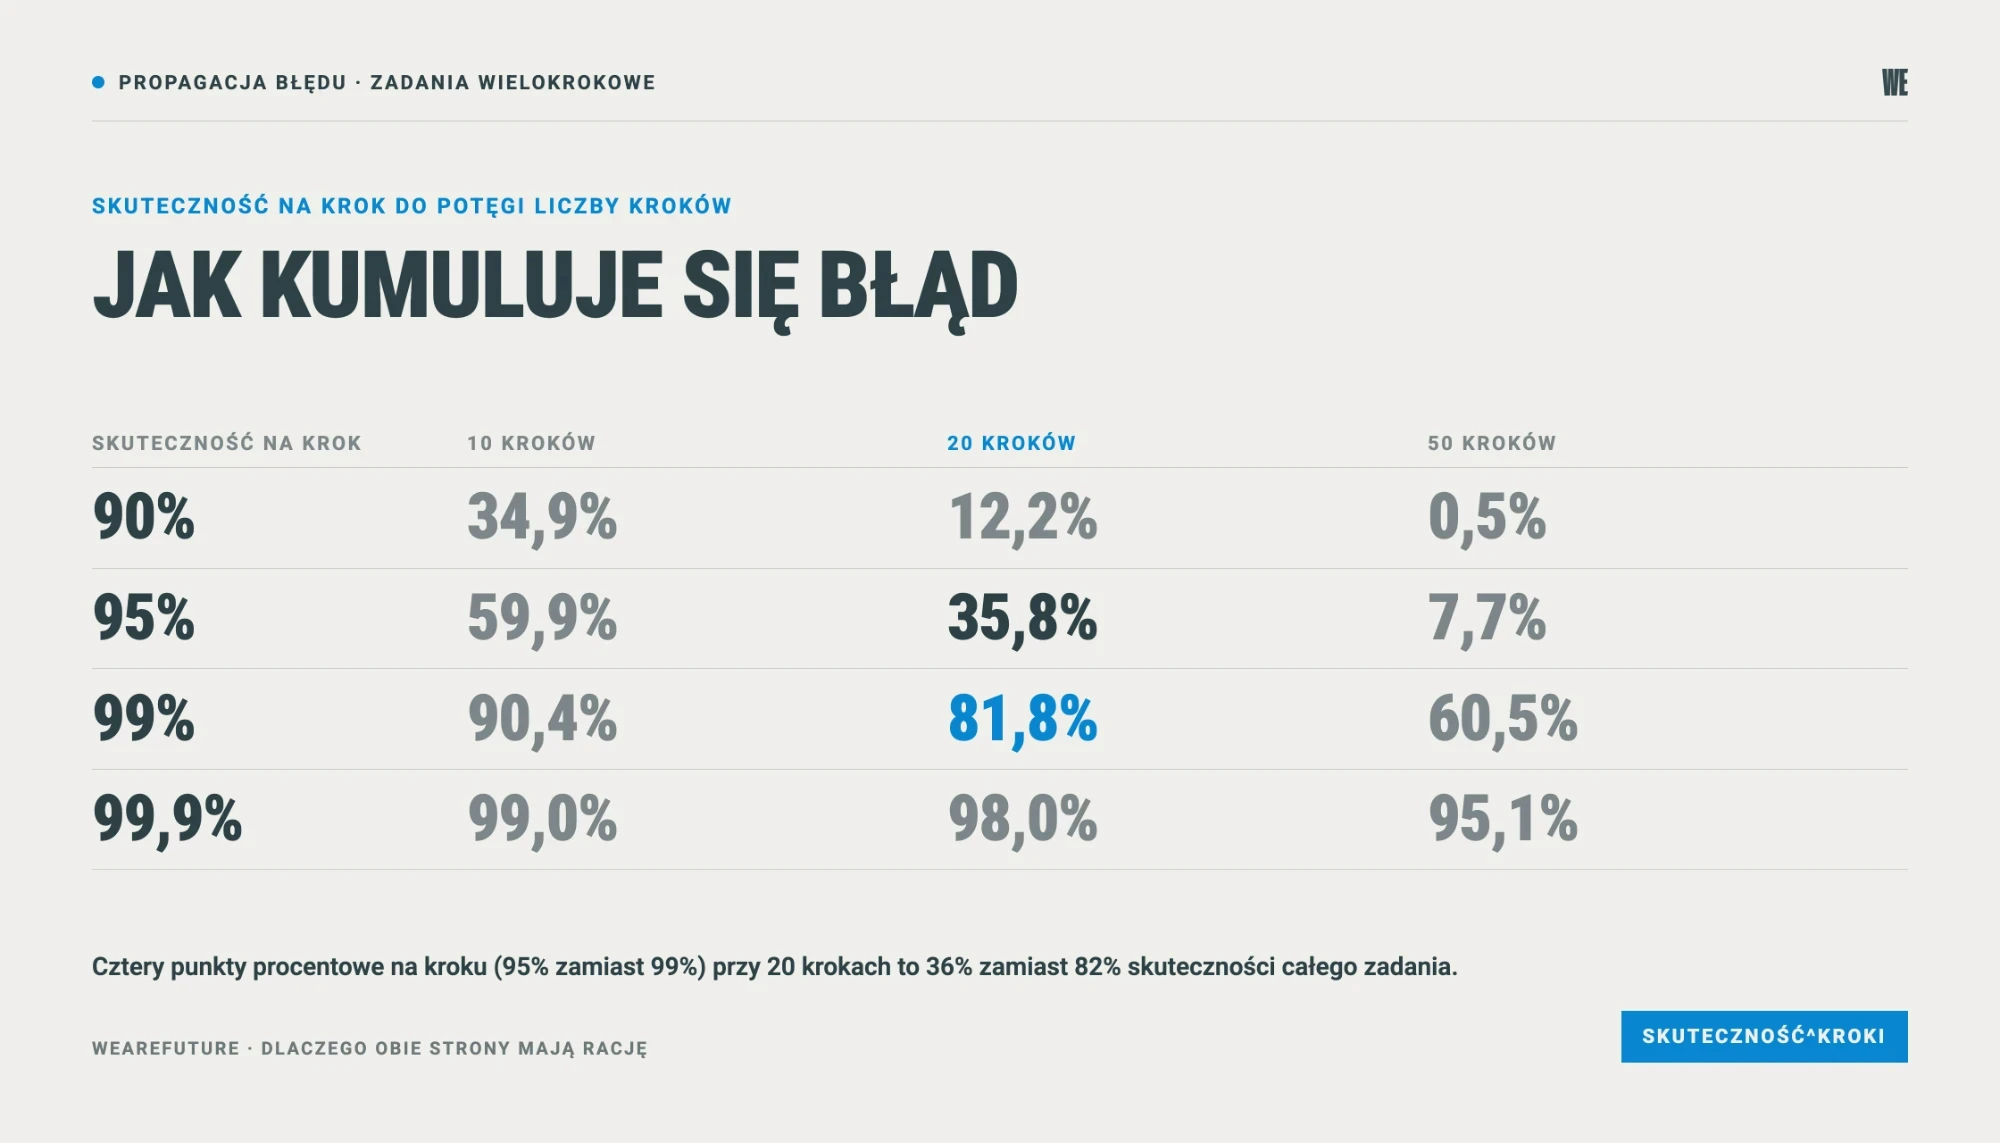
Przy 20 krokach 95% skuteczności na krok daje 36% skuteczności całego zadania, a 99% daje 82%.
Skuteczność na krok | 10 kroków | 20 kroków | 50 kroków |
|---|---|---|---|
90% | 34,9% | 12,2% | 0,5% |
95% | 59,9% | 35,8% | 7,7% |
99% | 90,4% | 81,8% | 60,5% |
99,9% | 99,0% | 98,0% | 95,1% |
W tej tabeli jest cały spór. Cztery punkty procentowe różnicy na pojedynczym kroku (95% zamiast 99%) przy 20 krokach zamieniają się w różnicę między niecałymi 36% a niemal 82% skuteczności na całości zadania. Stąd „ogromna różnica": przy długich, wielokrokowych zadaniach lepszy model po prostu dowozi, a słabszy się rozpada. I stąd zarazem złudzenie „pomijalnej różnicy": przy zadaniach na jeden, dwa, trzy kroki oba modele wyglądają praktycznie identycznie, bo błąd nie ma się jak nawarstwić.
Ta sama matematyka prowadzi do wniosku ważniejszego biznesowo, i to jest argument ZA harnessem. Skoro skuteczność zależy od dwóch rzeczy, jakości pojedynczego kroku i liczby kroków, to dobry harness gra na obu. Skraca liczbę krytycznych kroków. Wstawia checkpointy i walidację, żeby błąd nie propagował dalej, tylko został wyłapany od razu. Resetuje kontekst zamiast pozwalać mu gnić. Harness zmienia więc nie tylko podstawę potęgi (jakość kroku), ale i sam wykładnik (liczbę i strukturę kroków). Dlatego dobry harness na słabszym modelu potrafi pobić słaby harness na modelu lepszym.
Trzy klasy zadań: kiedy decyduje harness, a kiedy model?
Zamiast pytać „kto ma rację", lepiej zapytać „kiedy kto ma rację". Zadania AI dzielą się z grubsza na trzy klasy, a w każdej rozkład sił jest inny.
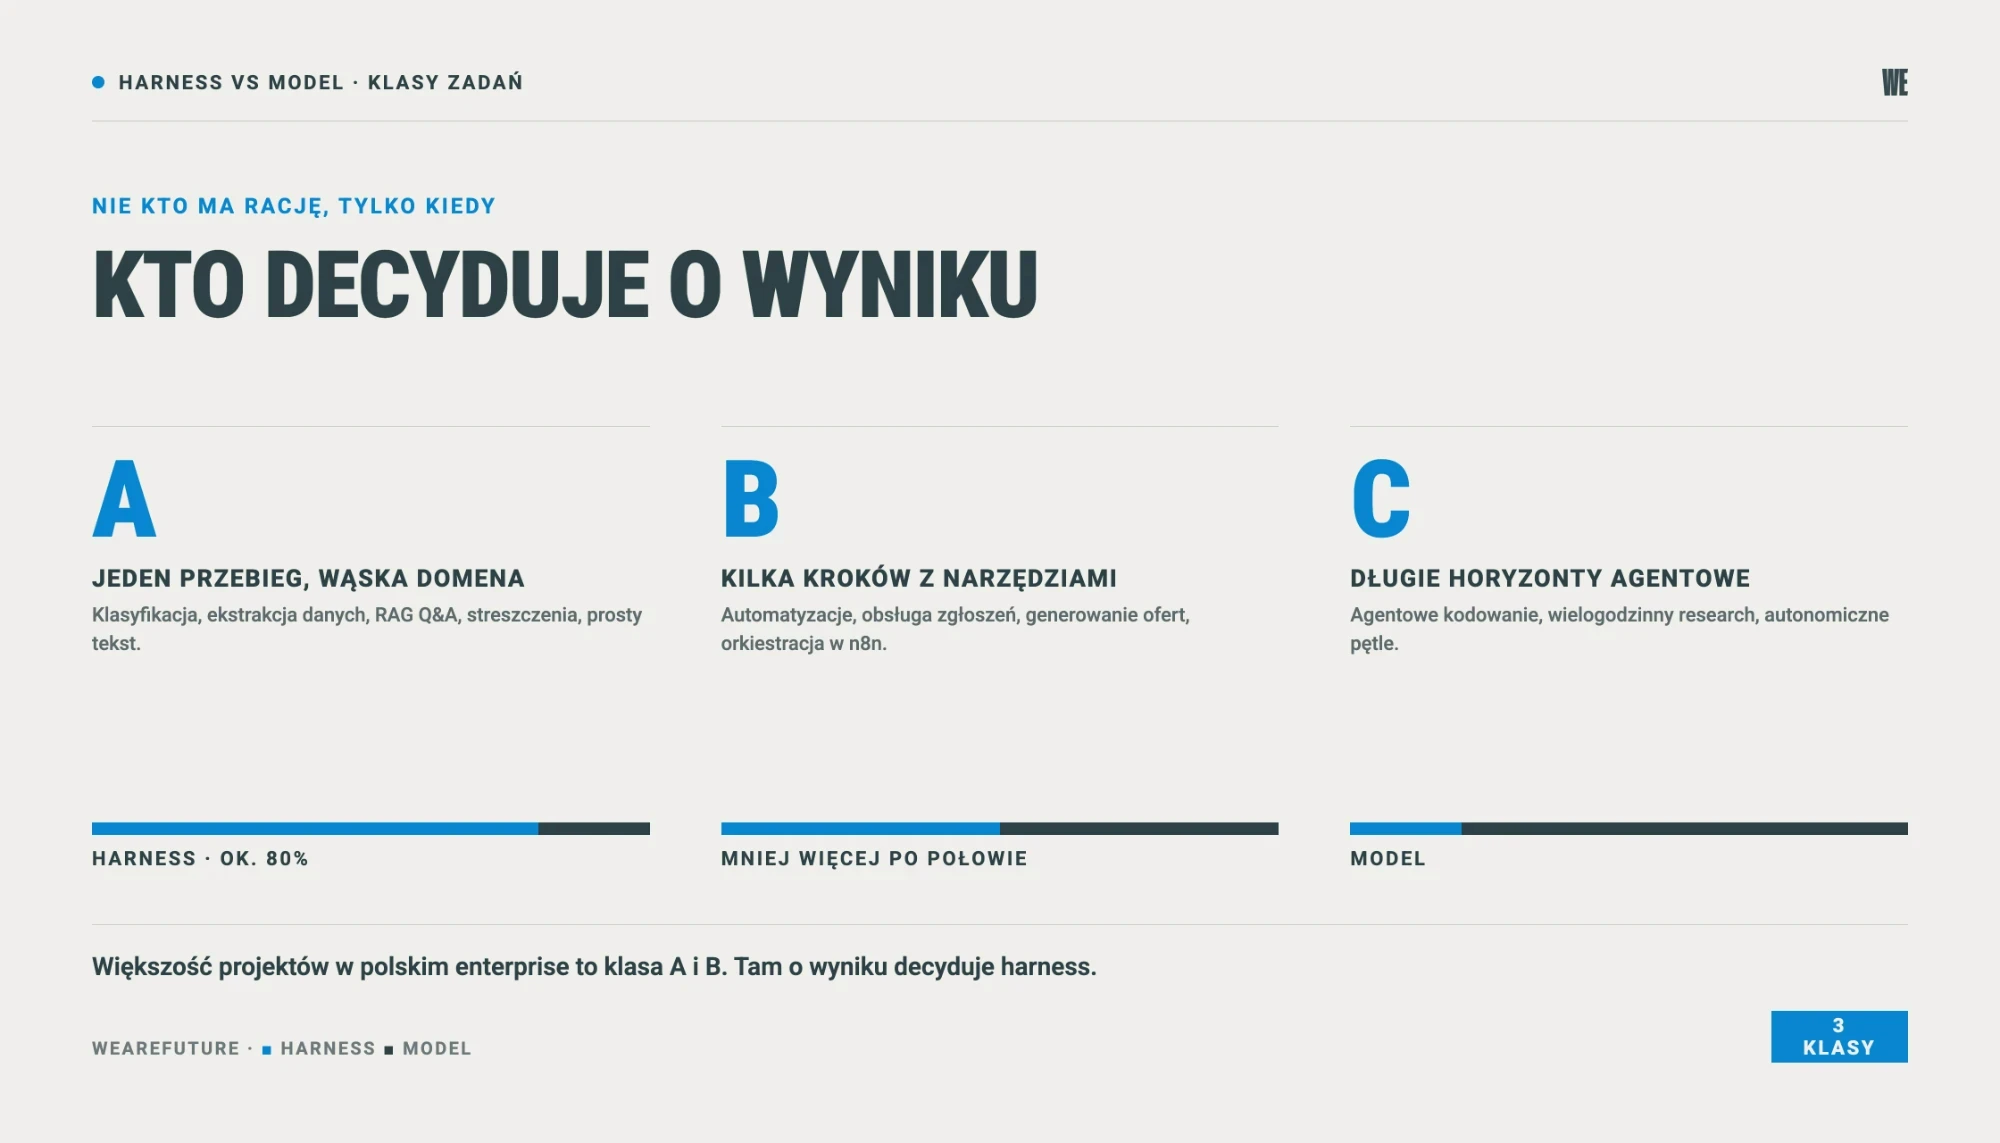
W zadaniach jednoprzebiegowych o wyniku decyduje harness, w długich zadaniach agentowych model.
Klasa zadania | Kto decyduje o wyniku | Przykłady |
|---|---|---|
A. Jeden przebieg, wąska domena | Harness (ok. 80%) | klasyfikacja, ekstrakcja danych, RAG Q&A, streszczenia, prosty tekst |
B. Kilka kroków z narzędziami | Mniej więcej po połowie | automatyzacje, obsługa zgłoszeń, generowanie ofert, orkiestracja w n8n |
C. Długie horyzonty agentowe | Model | agentowe kodowanie, wielogodzinny research, autonomiczne pętle |
Proporcje w tabeli to szacunek WeAreFuture z wdrożeń, nie wynik badania.
Klasa A to zadania jednoprzebiegowe w wąskiej domenie. Tu harness dominuje w jakichś 80%, a tani lub otwarty model w zupełności wystarcza. Ograniczeniem nie jest inteligencja modelu, tylko jakość danych i retrievalu. Jeśli model dostaje właściwy kontekst, poradzi sobie każdy z tej półki.
Klasa B to kilkukrokowe workflow z narzędziami. Tu podział sił jest mniej więcej po połowie. Rozstrzyga jakość użycia narzędzi (tool use) i stabilność, z jaką model trzyma się instrukcji przez kilka kroków. To dokładnie ten obszar, który opisywaliśmy przy różnicy między agentem a automatyzacją.
Klasa C to długie horyzonty agentowe: agentowe kodowanie, wielogodzinne zadania badawcze, autonomiczne pętle. Tu model dominuje, bo kumulacja błędu z tabeli powyżej zabija, a lepszy model wygrywa jednoznacznie. To jest pole, na którym zwolennicy tezy „model robi ogromną różnicę" mają pełną rację. To też pole, które przesuwa się najszybciej: według METR (2025) długość zadań, które modele frontier wykonują autonomicznie, podwaja się mniej więcej co 7 miesięcy.
I tu jest puenta dla polskiego rynku: zdecydowana większość projektów w rodzimym enterprise to klasa A i B, a nie C. Dlatego teza „o wyniku decyduje harness" jest prawdziwa dla wdrożeń biznesowych, a teza „bierz najlepszy model, bo tylko on się liczy" jest prawdziwa dla frontu badawczo-rozwojowego. Obie strony sporu opisują prawdę, tylko z dwóch różnych światów.
Pułapka: dlaczego tańszy model to nie automatyczna oszczędność?
Z tezy „harness ma większe znaczenie niż model" wiele osób wyciąga fałszywy wniosek: „skoro tak, podmieńmy model na najtańszy i zgarnijmy oszczędność". To pułapka, bo harness nie jest przenośny między modelami.
Scaffolding dopracowany pod model frontier milcząco zakłada kilka rzeczy: długie okno kontekstu, mocne i niezawodne użycie narzędzi, odporność na dryf instrukcji przez wiele kroków oraz sensowne planowanie. Przeniesiony na mniejszy model open source zwykle się sypie. Żeby przywrócić działanie, trzeba rozbić prompty na mniejsze, dołożyć walidacje, skrócić i uprościć kroki, dopisać logikę ponawiania, a czasem dorobić fine-tuning. To wszystko jest pracą inżynierską, i to nietrywialną.
W efekcie, przy typowych wolumenach polskiego mid-marketu, koszt inżynieryjny doprowadzenia otwartego modelu do parytetu zwykle przewyższa oszczędność na API. „Tańszy model" potrafi więc wyjść drożej, tylko koszt przenosi się z faktury za API na czas Twojego zespołu. Nie znaczy to, że open source jest zły. Znaczy to, że decyzja o modelu jest decyzją o całym systemie, a nie o pozycji w cenniku.
Praktyczna rekomendacja jest prosta: model frontier na warstwie decyzyjnej, tam gdzie liczy się jakość pojedynczego kroku i długie łańcuchy, a tani lub otwarty model na masówce, tam gdzie zadania są jednoprzebiegowe i wolumenowe. To nie jest wybór „albo, albo", tylko kwestia dopasowania modelu do klasy zadania.
Jak to wygląda w praktyce?
W naszych wdrożeniach widać to za każdym razem. W konfiguratorze produktowym budowanym dla producenta z branży wentylacji i ochrony przeciwpożarowej wybór konkretnego modelu językowego był jedną z ostatnich i najmniej istotnych decyzji. Wartość powstała gdzie indziej: w modelu danych, w sposobie przechowywania i wersjonowania stanu oraz w tym, jak agent sięga po dane produktowe. Gdyby zamienić tam model na inny z tej samej półki, użytkownik nie zauważyłby różnicy, bo o jakości decyduje obudowa, nie silnik.
Podobnie w agencie obsługującym zapytania ofertowe, opartym na orkiestracji z integracjami do systemów firmy (ERP, CRM, baza wiedzy). Jakieś 80% pracy stanowiły tam integracje, projekt pętli i walidacja, a nie sam prompt czy wybór modelu. To podręcznikowy przykład zadania klasy B, w którym o wyniku rozstrzyga harness. Gdyby ktoś kazał temu zespołowi „wdrożyć najlepszy model i tyle", zacząłby od najmniej ważnej zmiennej i ominął to, co faktycznie tworzy wartość.
Wspólny mianownik jest zawsze ten sam: o wyniku decydują inżynieria, dane i proces wokół modelu. Dokładnie to, o czym pisaliśmy przy plikach kontekstowych i skillach, bo context engineering to jeden z filarów harnessu, i przy wdrożeniach AI od chaosu do uporządkowania.
Checklista decyzyjna dla CIO i CTO
Zanim podejmiesz decyzję „jaki model", przejdź przez te pytania. Są ważniejsze niż nazwa modelu w ofercie.
Ile kroków ma Twoje zadanie? Jeden, kilka, czy kilkadziesiąt? To od razu mówi, czy jesteś w klasie A, B czy C, i czy model w ogóle będzie wąskim gardłem.
Jaki jest koszt pojedynczego błędu? Inna jest stawka przy streszczeniu maila, inna przy decyzji finansowej. Im wyższa, tym więcej walidacji i tym ważniejsza jakość kroku.
Czy mierzysz skuteczność na krok? Jeśli nie mierzysz, nie wiesz, gdzie tracisz, i rozmowa o modelu jest rozmową o wrażeniach.
Czy masz evale i monitoring regresji? Bez tego każda zmiana modelu czy promptu to skok w ciemność.
Czy Twój scaffolding jest model-agnostic? Czy zmiana modelu to zmiana konfiguracji, czy przepisanie połowy systemu? To pytanie decyduje o faktycznym koszcie „tańszego modelu".
Gdzie w procesie błąd może propagować i czy masz checkpointy? Miejsca bez walidacji to miejsca, w których jeden zły krok psuje całość.
Czy masz warstwę kontekstu i pamięci? Bez niej model za każdym razem zaczyna od zera, a Ty płacisz za to jakością i tokenami.
Na co idzie Twój budżet AI? Jeśli w całości na licencje modeli, a nie na obudowę, prawdopodobnie inwestujesz w najmniej różnicującą część systemu.
Jeśli na większość tych pytań odpowiedź brzmi „nie wiem", masz gotową listę rzeczy do uporządkowania, zanim wydasz złotówkę na „lepszy model".
Nie wybieraj modelu. Zaprojektuj system
Spór o open source kontra frontier jest źle postawiony. Model to zmienna, nie fundament. Fundamentem jest system wokół niego: instrukcje, kontekst, narzędzia, pętla, guardraile i warstwa operacyjna. To one decydują, czy z tej samej technologii wyjdzie działające wdrożenie, czy efektowne demo, które rozpada się na produkcji.
Dlatego w naszej pracy zaczynamy nie od pytania „jaki model", lecz od projektu systemu, i utrzymujemy zasadę niezależności od dostawcy modeli. Model dobiera się do klasy zadania na końcu, gdy reszta jest już zaprojektowana. Ta sama logika stoi za naszą metodyką AI SYSTEM: najpierw architektura, dane i proces, potem konkretne wdrożenia, a wybór modelu to jedna z ostatnich, wymiennych decyzji. Jak całość składa się w szerszą transformację AI w firmie, opisujemy osobno.
Jeśli stoisz przed decyzją, w co zainwestować budżet AI, to dobry moment, żeby spojrzeć na cały system, a nie tylko na nazwę modelu. Zobacz nasze doradztwo i strategię AI albo to, jak prowadzimy wdrożenia AI, i umów rozmowę, a pokażemy, gdzie w Twoim przypadku leży wartość.
Najczęściej zadawane pytania (FAQ)
Czym jest harness w AI?
Harness to cała obudowa, która zamienia surowy model w działający system: instrukcje i pliki kontekstowe, context engineering (retrieval, pamięć), narzędzia, pętla agenta, guardraile, scaffolding oraz warstwa operacyjna (routing, evale, monitoring). Model generuje tekst, a harness sprawia, że z tego generowania powstaje coś, co wykonuje zadanie. Dla większości zastosowań biznesowych to harness, a nie sam model, decyduje o wyniku.
Czy wybór modelu w ogóle ma znaczenie?
Ma, ale zależy od zadania. Przy krótkich, jednoprzebiegowych zadaniach różnice między dobrymi modelami są niewielkie. Przy długich, wielokrokowych zadaniach agentowych lepszy model wygrywa jednoznacznie, bo błąd kumuluje się wykładniczo. Model jest też podstawą, na której stoi harness. Dlatego prawidłowa odpowiedź to nie „model nie ma znaczenia", lecz „dla większości wdrożeń biznesowych decyduje harness, a model dobiera się do klasy zadania".
Czy model open source wystarczy zamiast modelu frontier?
Dla wielu zadań jednoprzebiegowych (klasyfikacja, ekstrakcja, RAG) często tak, bo ograniczeniem jest tam jakość danych, nie inteligencja modelu. Dla długich zadań agentowych zwykle nie. Uwaga na pułapkę: harness dopracowany pod model frontier nie przenosi się wprost na mniejszy model, a koszt doprowadzenia go do parytetu potrafi przewyższyć oszczędność na API.
Dlaczego ten sam model daje różne wyniki w różnych narzędziach?
Bo różni je harness. Ten sam model wpięty w lepszą obudowę (lepszy kontekst, narzędzia, pętlę, walidację) daje radykalnie lepszy wynik niż w słabej. LangChain podniósł wynik swojego agenta w Terminal Bench 2.0 z 52,8% do 66,5% samą zmianą harnessu, bez zmiany modelu.
Co to jest context engineering?
To dbanie o to, co trafia do okna kontekstu modelu: właściwy retrieval, kompakcja, pamięć długoterminowa i porządek w tym, czym model dysponuje. To jeden z filarów harnessu i temat, który rozwijamy osobno przy plikach kontekstowych i skillach. Bez dobrego kontekstu nawet najlepszy model pracuje na jałowym gruncie.
Czy zmiana modelu na tańszy obniży koszty?
Nie zawsze. Sama faktura za API może spaść, ale jeśli tańszy model wymaga przepisania scaffoldingu, dodania walidacji i skrócenia kroków, koszt przenosi się na czas zespołu i potrafi przewyższyć oszczędność. Przy typowych wolumenach mid-marketu policz to, zanim przełączysz. To decyzja o całym systemie, nie o pozycji w cenniku.
Od czego zależy skuteczność agenta AI?
Od dwóch rzeczy naraz: jakości pojedynczego kroku i liczby kroków. Skuteczność całości to skuteczność kroku podniesiona do potęgi liczby kroków, więc drobne różnice kumulują się wykładniczo: przy 20 krokach 95% na krok daje 35,8% na całości, a 99% daje 81,8%. Dobry harness poprawia oba czynniki: podnosi jakość kroku i skraca oraz zabezpiecza łańcuch kroków checkpointami, żeby błąd nie propagował.
Jak wybrać model do wdrożenia?
Zacznij od klasy zadania i liczby kroków, a nie od ogólnych benchmarków. Dla zadań wolumenowych i jednoprzebiegowych wystarczy tani lub otwarty model. Dla warstwy decyzyjnej i długich łańcuchów sięgnij po model frontier. Najpierw zaprojektuj system (dane, kontekst, narzędzia, pętlę), a wybór modelu potraktuj jako jedną z ostatnich, wymiennych decyzji.
Źródła
LangChain, Improving Deep Agents with harness engineering - wynik agenta w Terminal Bench 2.0 z 52,8% do 66,5% bez zmiany modelu (gpt-5.2-codex).
Zhang i in. (2026), Stop Comparing LLM Agents Without Disclosing the Harness, arXiv:2605.23950 - harness jako silniejszy wyznacznik wyniku agenta niż model przy zadaniach długohoryzontowych.
METR (2025), Measuring AI Ability to Complete Long Tasks - długość zadań wykonywanych autonomicznie przez modele podwaja się co ok. 7 miesięcy.
Anthropic, Effective context engineering for AI agents - context engineering jako dyscyplina budowy agentów.
EleutherAI, lm-evaluation-harness - pochodzenie terminu „harness" w ewaluacji modeli.
Tabela propagacji błędu: obliczenia własne WeAreFuture (skuteczność na krok podniesiona do potęgi liczby kroków). Proporcje klas A/B/C i udział pracy przy agencie ofertowym: dane z wdrożeń WeAreFuture (2026).